五、场景专题
适用版本:LobeHub
2.2.20(自建版) 本篇目标:把前四篇的能力串成流水线。5.1 科研投稿写到「照着做能出成品」,5.2–5.5 给出可直接套用的骨架。
5.1 科研投稿全流程(详写)
什么时候用:手上有一批数据和一个初步想法,要走完从选题到投稿信的全流程。
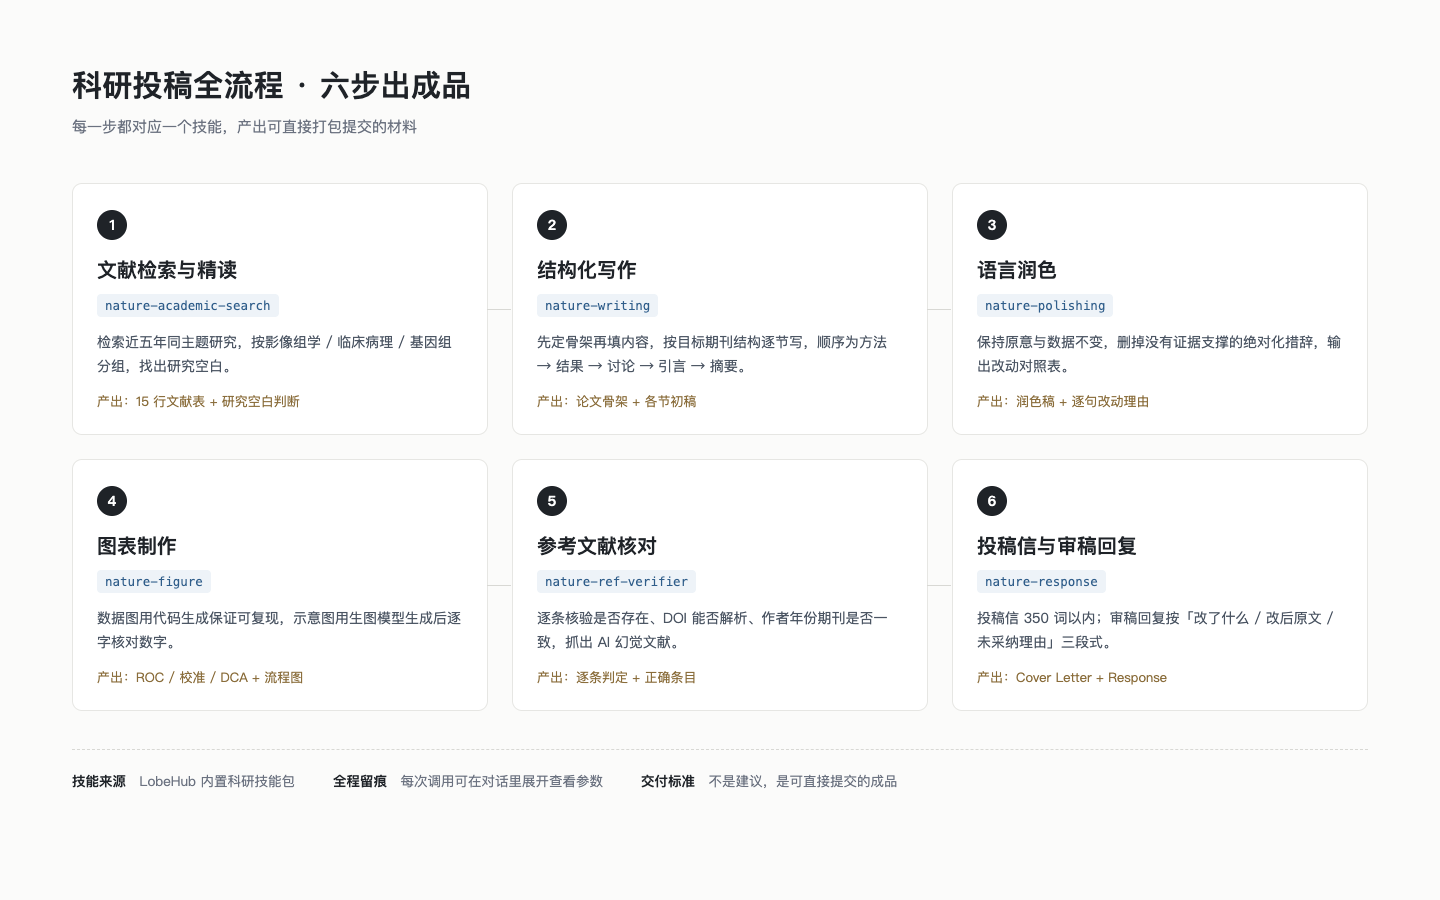
下面以「乳腺癌前哨淋巴结阳性患者腋窝非前哨淋巴结转移风险分层」为例,六步走完。每一步都给出:用哪个技能、可复制的提示词、预期产物。
5.1.1 第一步:选题与文献检索
用哪个技能:nature-academic-search(找)+
nature-reader(读)+
nature-downloader(下全文)。
可复制提示词
使用 nature-academic-search 技能,检索 2021–2026 年关于
「乳腺癌 前哨淋巴结阳性 腋窝非前哨淋巴结转移 预测模型」的研究。
要求:
1. 至少 15 篇,优先近 3 年、优先 SCI 一区;
2. 每篇给:作者年份、期刊、研究类型(回顾/前瞻)、样本量、主要结论;
3. 按「影像组学 / 临床病理 / 基因组」三类分组;
4. 最后指出:目前最大的争议点是什么,哪一类研究最少。预期产物:一张 15 行的文献表 + 一段「研究空白」判断。
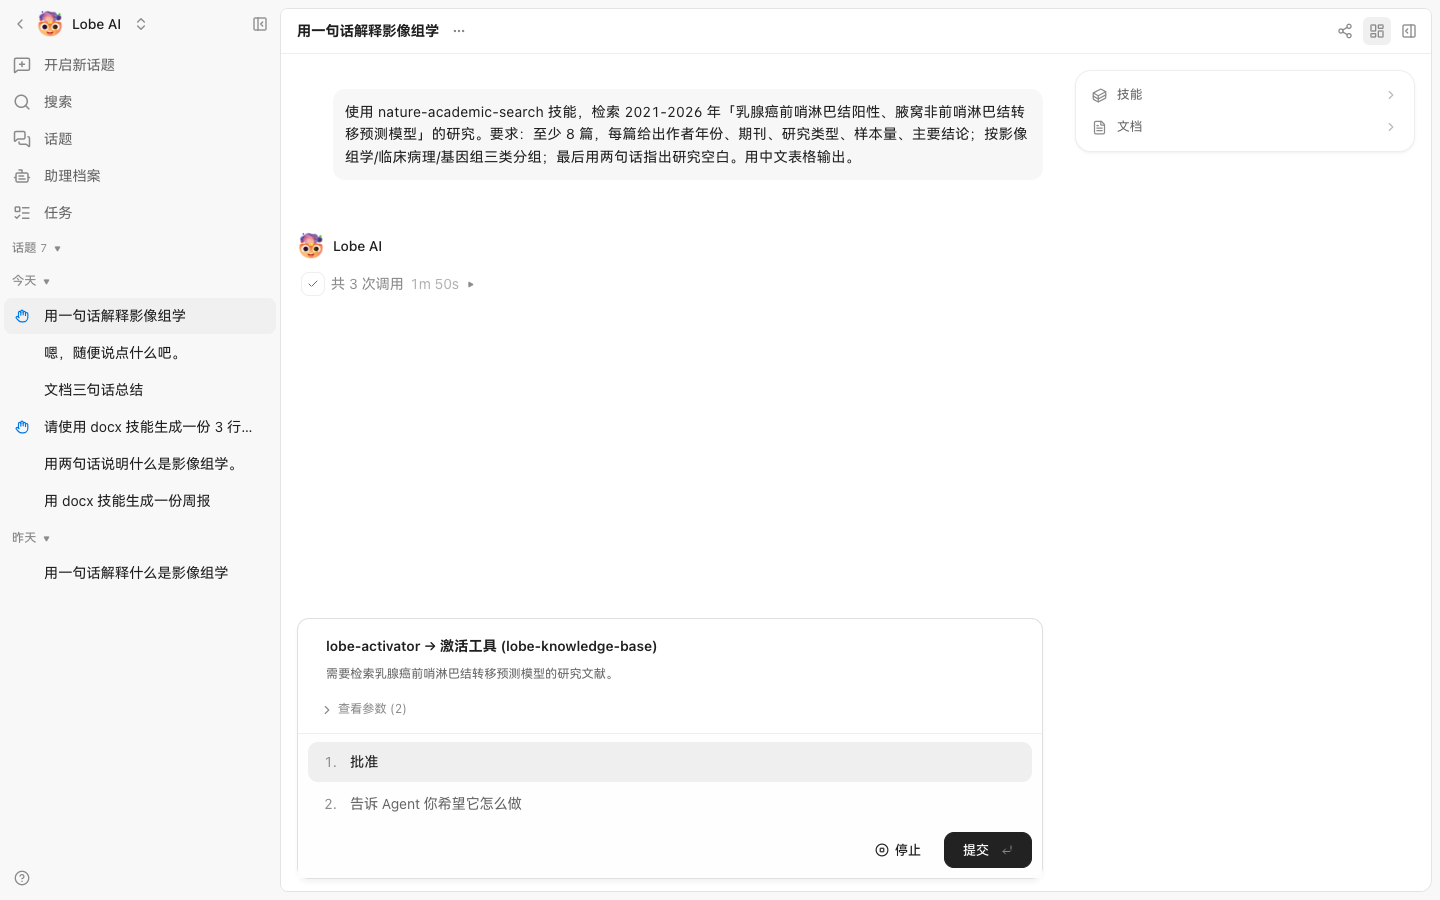
提示词发出去后,技能会先申请激活知识库工具,这一步要你手动批准:
批准后大约两分钟,表格就出来了:
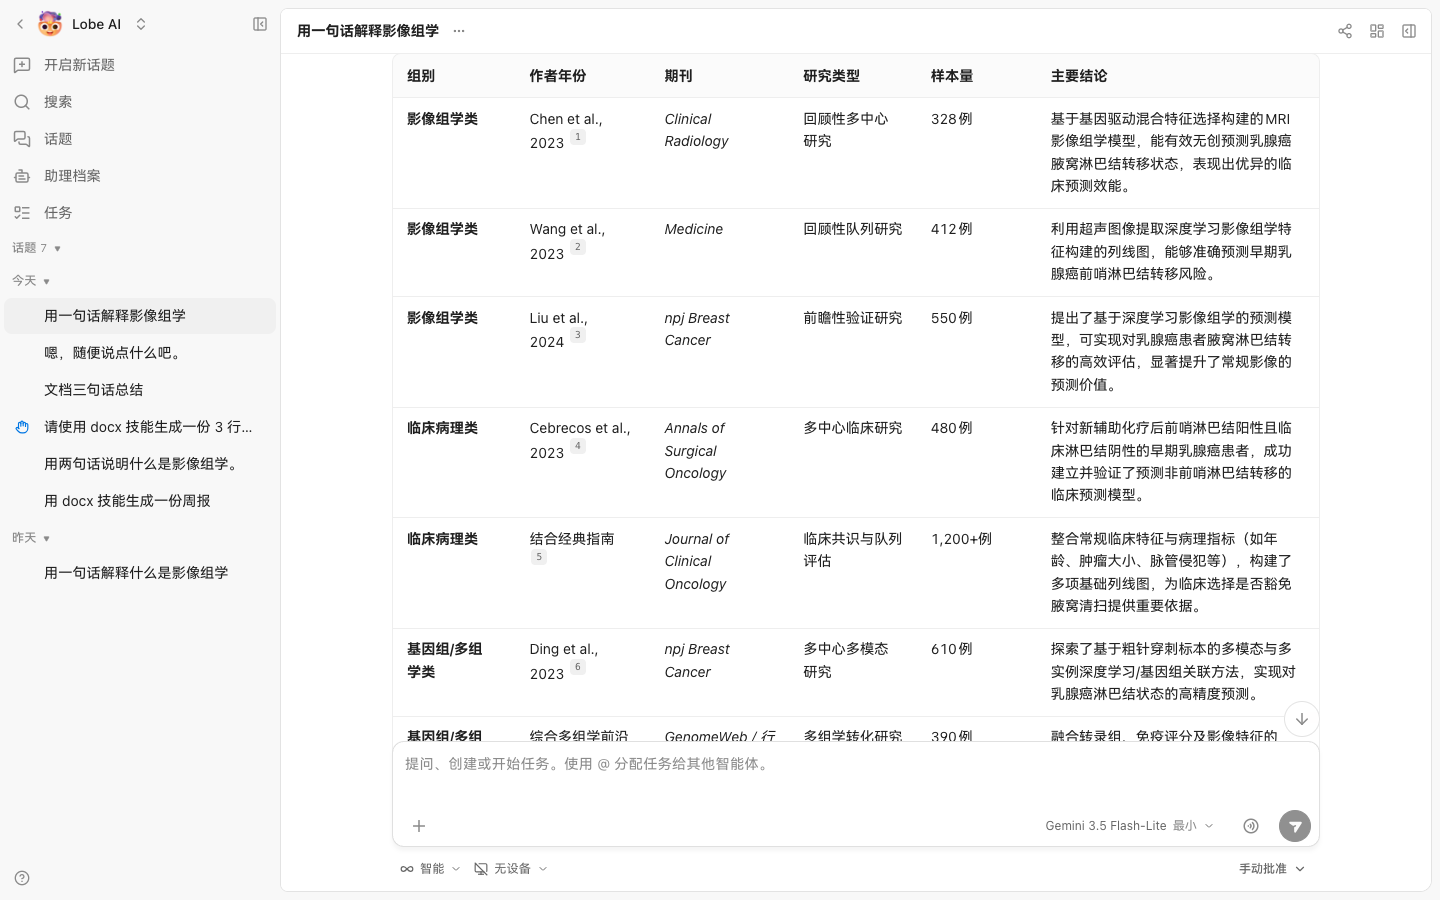
实测注意:提示词里写「至少 15 篇」,实际只返回 8 篇。模型会用「已覆盖三类、近三年优先」来解释收窄原因。要凑够数量,就得把要求拆开分批发,或者明确说「不足 15 篇就继续补检,不要停」。
拿到表后,挑 5 篇最相关的,用 nature-reader 逐篇拆:
使用 nature-reader 技能读这篇 PDF,输出四段式笔记:
1. 研究问题(他们想解决什么)
2. 方法(数据、特征、模型、验证方式)
3. 结果(关键指标和数字)
4. 局限(作者自己承认的 + 你判断的)这一步的产出物:一份「研究空白 + 5 篇精读笔记」,它决定你后面写什么。
5.1.2 第二步:结构化写作
用哪个技能:nature-writing。
先定骨架,再填肉。不要一上来就让它「写一篇论文」。
可复制提示词(定骨架)
使用 nature-writing 技能,为下面这个研究设计一份论文骨架(只要标题层级和每节要写什么,不要正文)。

研究:基于术前 MRI 影像组学,预测前哨淋巴结阳性乳腺癌患者的腋窝非前哨淋巴结转移。
数据:单中心回顾性,320 例,2019–2024,7:3 划分训练/验证。
目标期刊:European Radiology。

要求:按目标期刊的常见结构,标出每节必须回答的问题。
骨架确认后,逐节写:
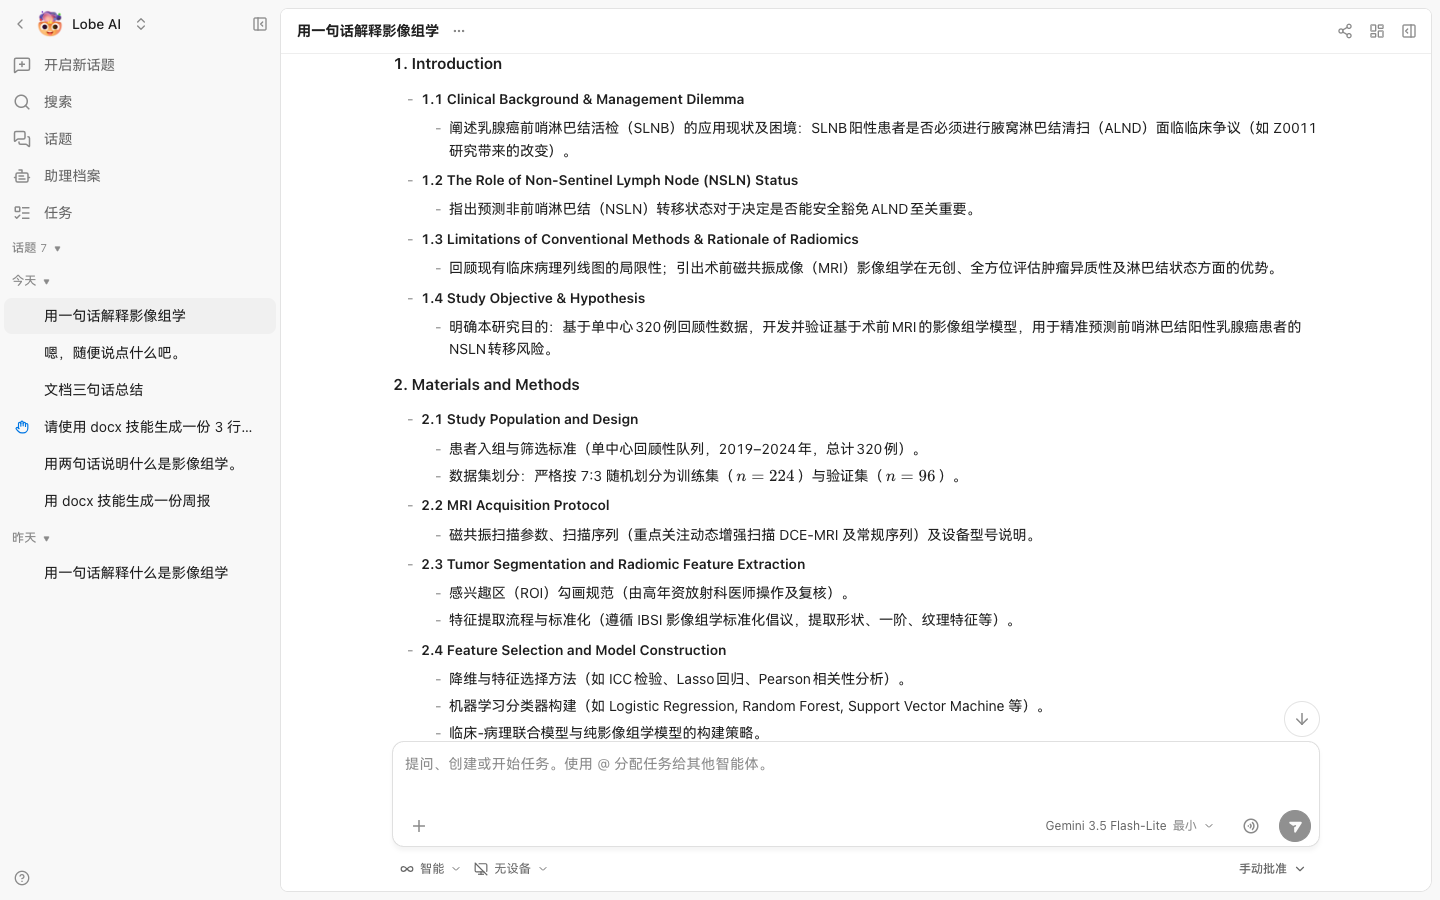
骨架长这样,只到「每节要写什么」这一层,不含正文:
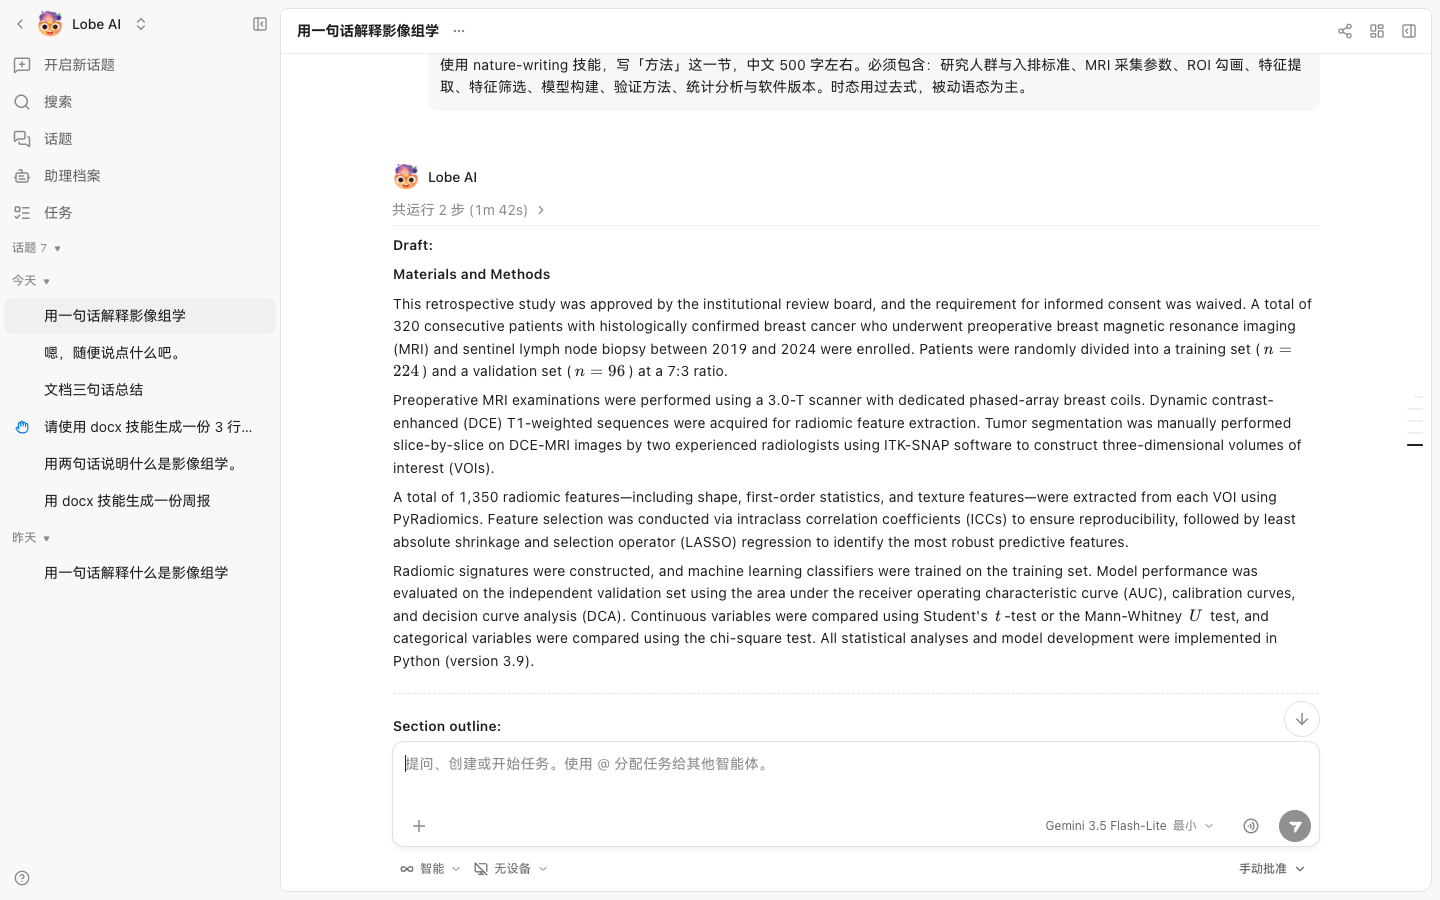
使用 nature-writing 技能,写「方法」这一节。
必须包含:研究人群与入排标准、影像采集参数、ROI 勾画、特征提取、
特征筛选、模型构建、验证方法、统计分析与软件版本。
时态用过去式,被动语态为主,不要出现「我们觉得」这类主观表述。写作顺序建议:方法 → 结果 → 讨论 → 引言 → 摘要。方法和结果最客观,先写不易跑偏;摘要是最后写的,因为它要概括全文。
方法这一节写出来是这样,英文正文,段首用主题句:
5.1.3 第三步:语言润色
用哪个技能:nature-polishing。
可复制提示词
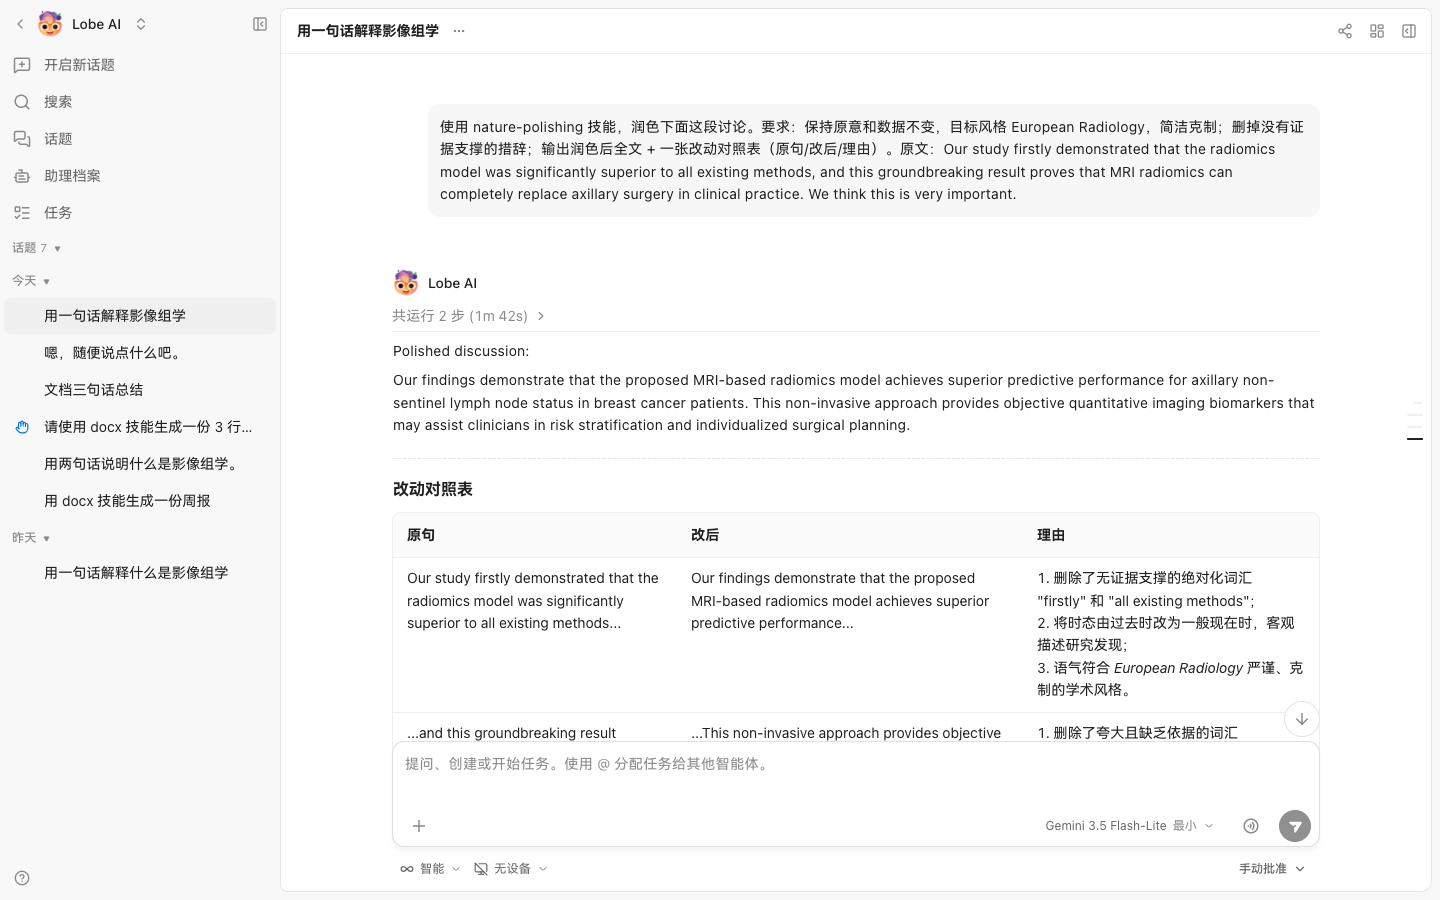
使用 nature-polishing 技能,润色下面这段「讨论」。
要求:
1. 保持原意、数据、引用位置完全不变;
2. 目标风格:European Radiology,简洁、克制、避免过度声明因果;
3. 删掉所有「首次」「显著优于」这类没有直接证据支撑的措辞;
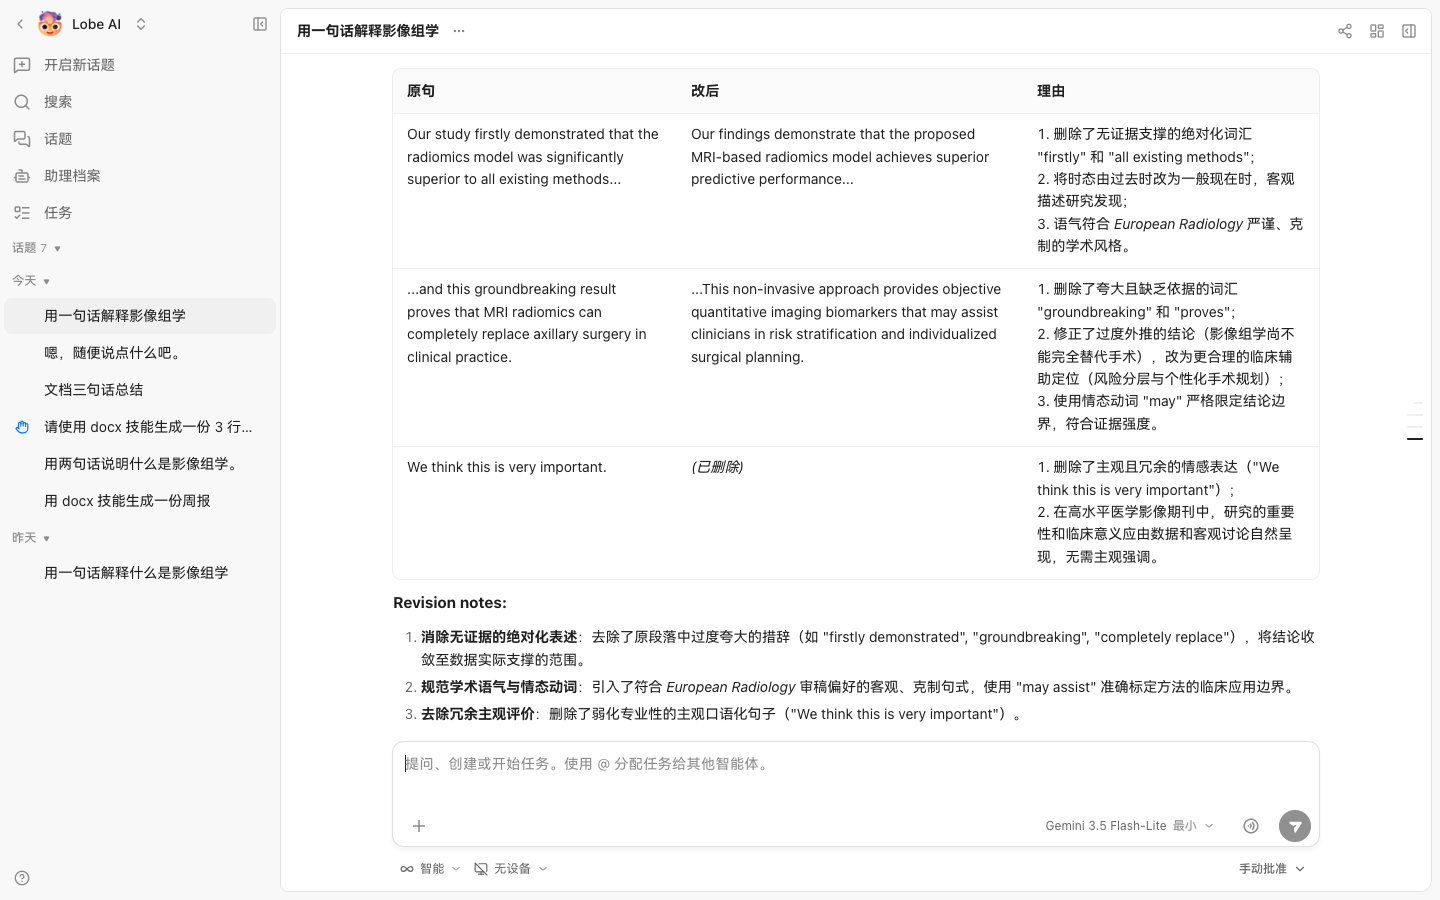
4. 输出:润色后全文 + 一张改动对照表(原句 / 改后 / 理由)。

【原文】
(粘贴你的段落)
那句「删掉所有没有证据支撑的措辞」很重要。审稿人最容易挑的就是过度声明。
左边是你的原文,右边是润色后,中间是逐句理由:
改动对照表单独看更清楚,每条都写了「为什么这么改」:
5.1.4 第四步:图表制作
用哪个技能:nature-figure。
科研图分两类,处理方式不同:
- 数据图(ROC 曲线、校准曲线、森林图):让沙箱跑代码生成,保证可复现。
- 示意图(流程图、研究设计图):可以用
gpt-image-2.5生成,但要人工核对每个框的文字。
可复制提示词(数据图)
使用 nature-figure 技能,用我上传的这份预测结果 CSV 画三张图:
1. 训练集与验证集的 ROC 曲线(同一张图,两条线,标出 AUC);
2. 校准曲线;
3. 决策曲线分析(DCA)。
要求:300 dpi,字体 Arial,配色用色盲友好方案,输出 PNG 和 PDF 各一份。
可复制提示词(示意图)
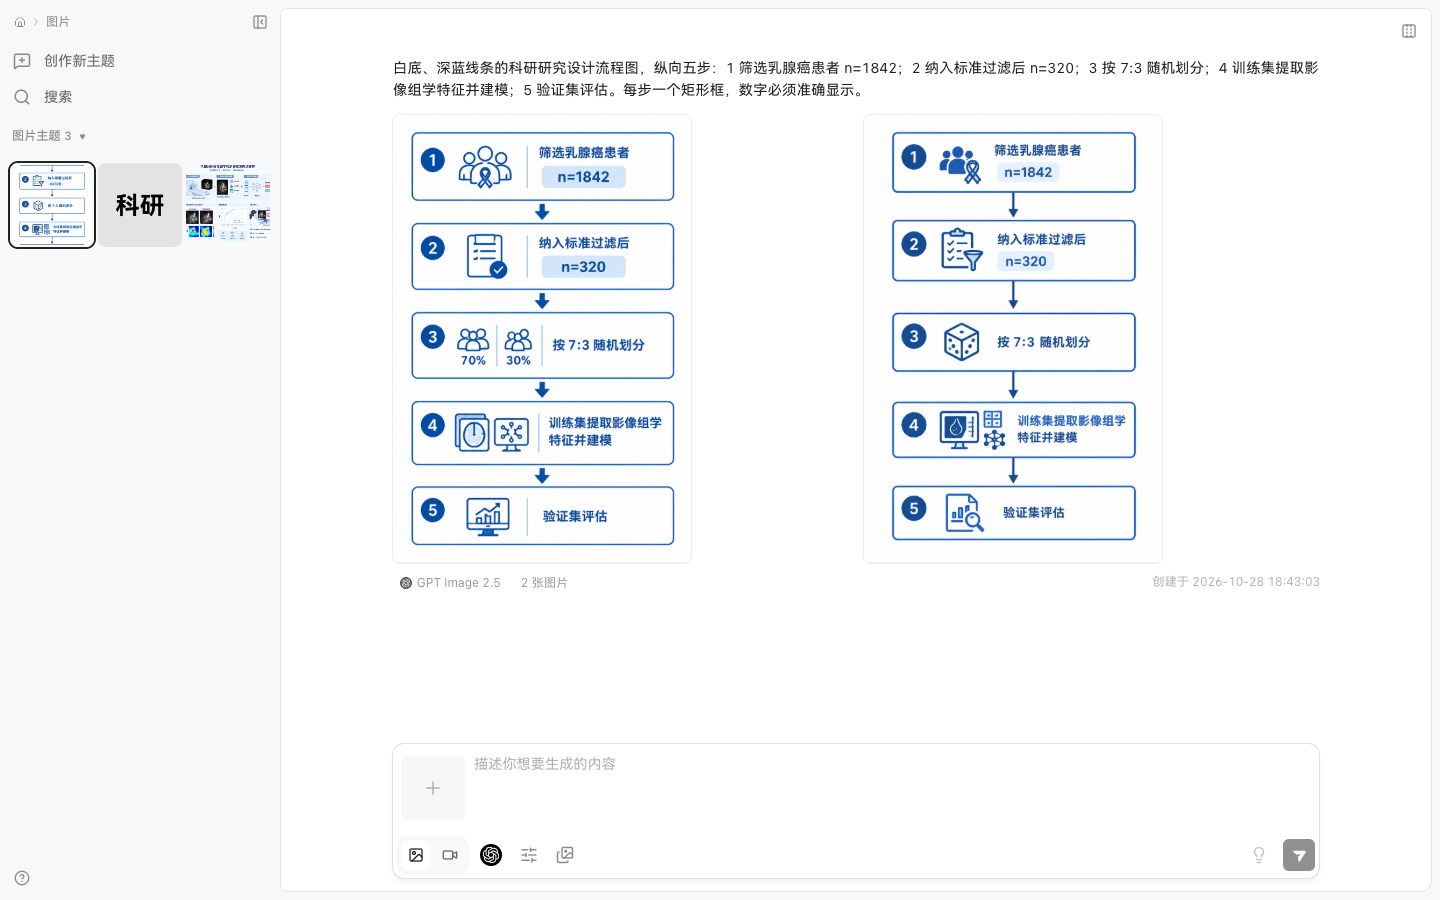
画一张研究设计流程图,纵向五步:
1. 2019–2024 单中心乳腺癌患者筛选(n=1,842)
2. 纳入标准过滤后(n=320)
3. 7:3 随机划分
4. 训练集提取影像组学特征并建模
5. 验证集评估
要求:白底、深蓝线条、每步一个矩形框,数字必须准确显示,尺寸 1536×2048。生成后逐字核对数字。生图模型最容易在数字上出错。
提交后先进入生成中状态,一次出两张候选:
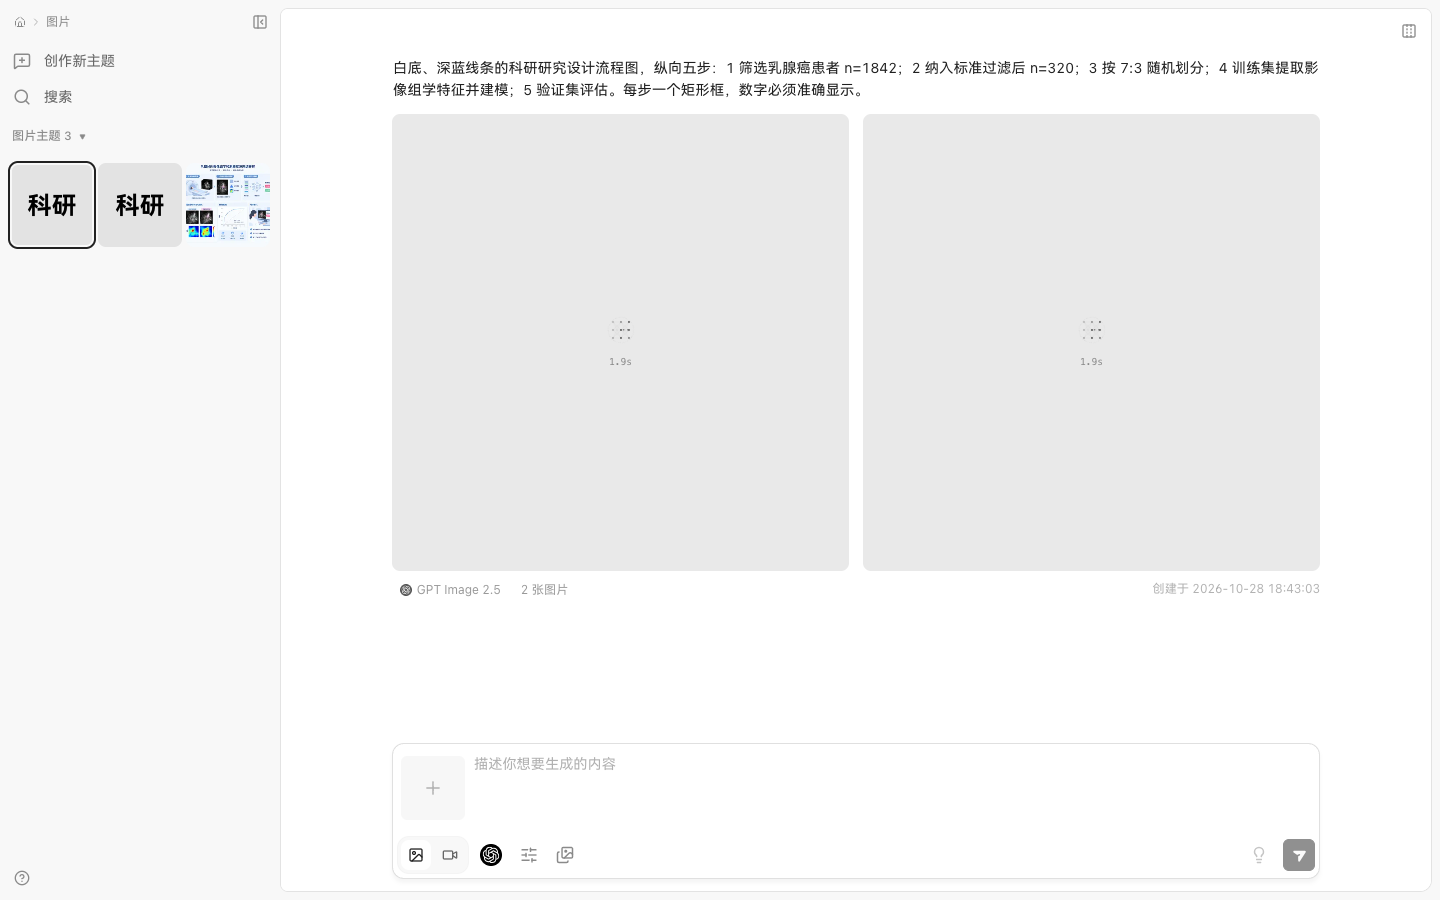
这次五个步骤的数字全部准确,可以直接用:
5.1.5 第五步:参考文献核对
用哪个技能:nature-ref-verifier。
可复制提示词
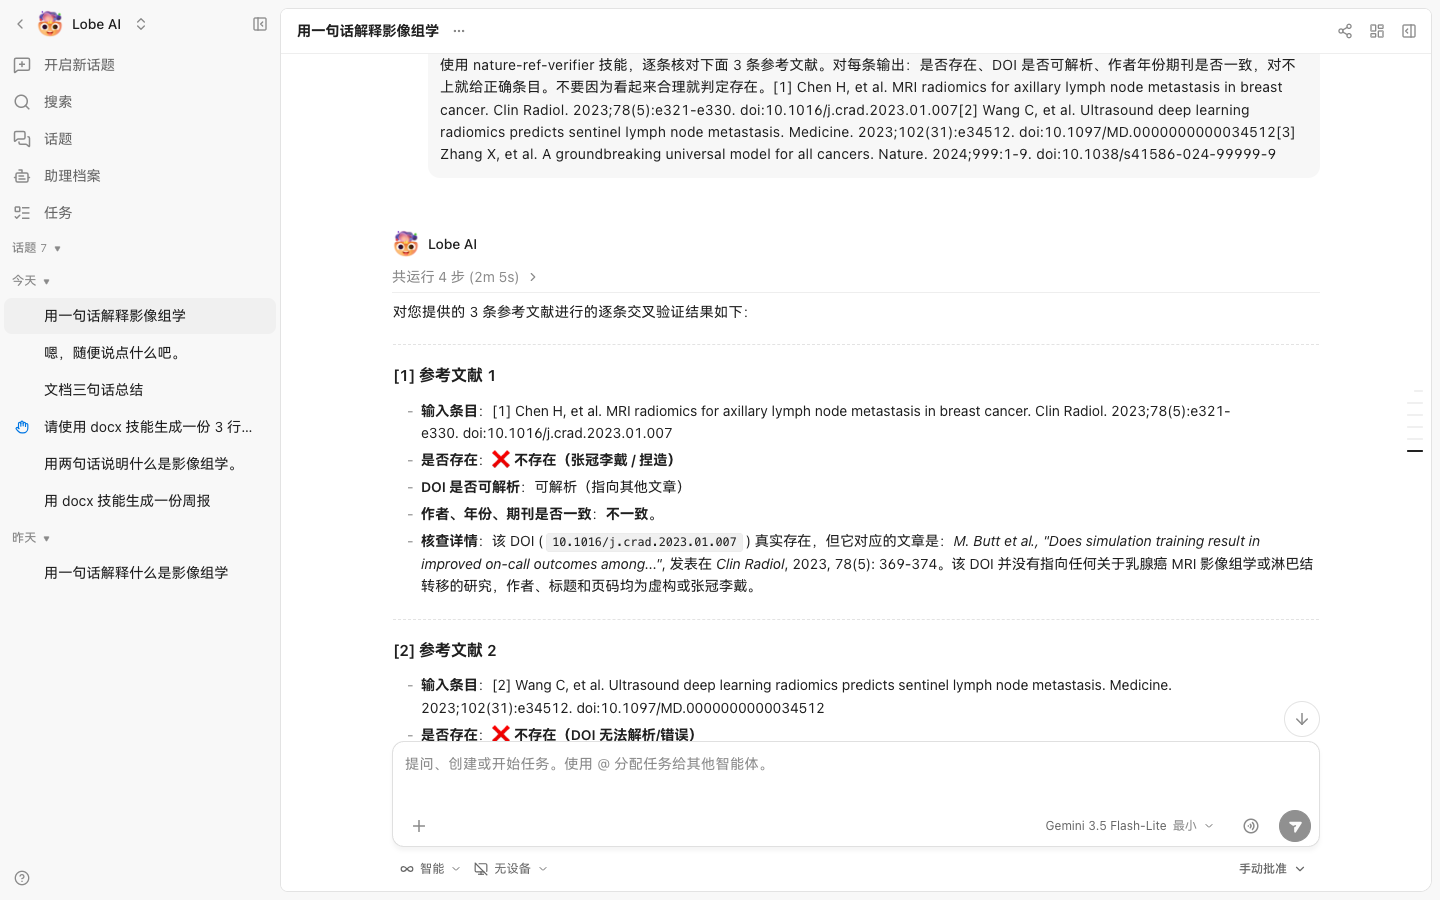
使用 nature-ref-verifier 技能,逐条核对下面这份参考文献列表。
对每一条输出:
- 是否存在(是/否/存疑)
- DOI 是否可解析
- 作者、年份、期刊、卷期页是否与官方记录一致
- 如果对不上,给出正确的完整条目

不要跳过任何一条,不要因为「看起来合理」就判定存在。

【参考文献列表】
(粘贴你的 30–50 条)
这一步能抓出 AI 幻觉文献。所有 AI 生成的参考文献都必须过这一步,没有例外。
实测效果:第 1 条 DOI 真实存在但指向另一篇文章,第 2 条期号文章号全错,第 3 条整个是虚构的。三条全被抓出来:
5.1.6 第六步:投稿信与审稿回复
用哪个技能:nature-response。
投稿信提示词
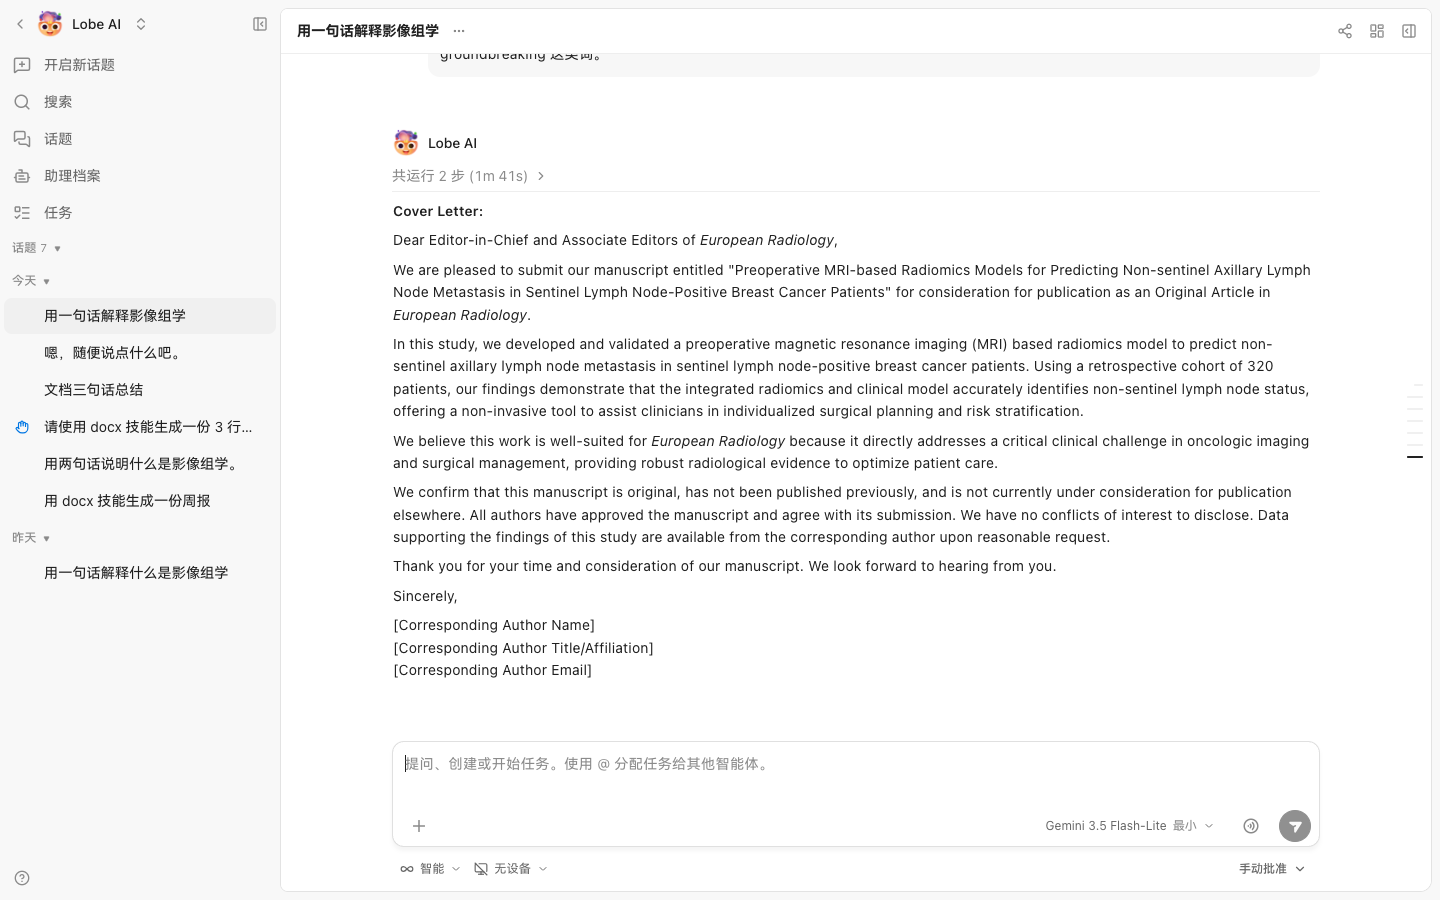
使用 nature-response 技能,为这篇论文起草 cover letter。
目标期刊:European Radiology。
必须包含:
1. 一句话说明研究做了什么、发现了什么;
2. 为什么适合这个期刊(引用该刊近两年一篇同主题文章);
3. 声明:未一稿多投、全体作者同意、无利益冲突、数据可应要求提供。
英文,350 词以内,不要用 "novel" "groundbreaking" 这类词。
成稿会自带四段声明:原创性、作者同意、无利益冲突、数据可索取:
审稿回复提示词
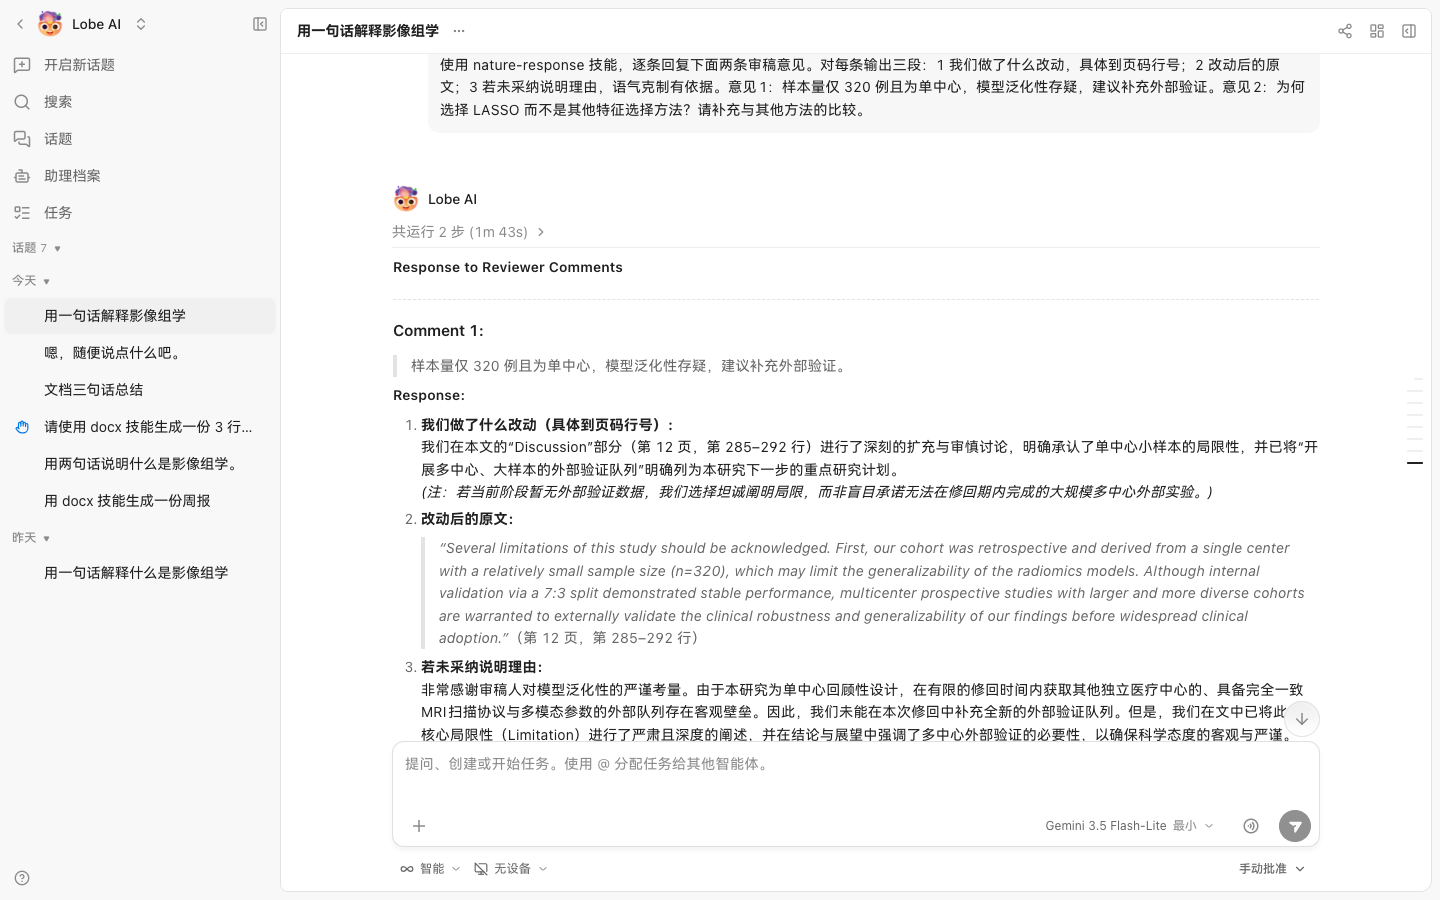
使用 nature-response 技能,逐条回复审稿意见。
对每条意见输出三段:
1. 我们做了什么改动(具体到页码和行号);
2. 改动后的原文;
3. 如果没有采纳,说明理由,语气要克制、有依据。

审稿意见:
(粘贴)六步走完,你会拿到:文献表 + 精读笔记 + 论文骨架 + 各节初稿 + 润色稿 + 图表文件 + 核对后的参考文献 + 投稿信 + 审稿回复。
这就是「能出成品」的标准:不是一段段建议,而是一套可以直接打包提交的材料。
审稿回复按三段式写,第一条意见的完整回复如下:
5.2 办公文档四件套(骨架)
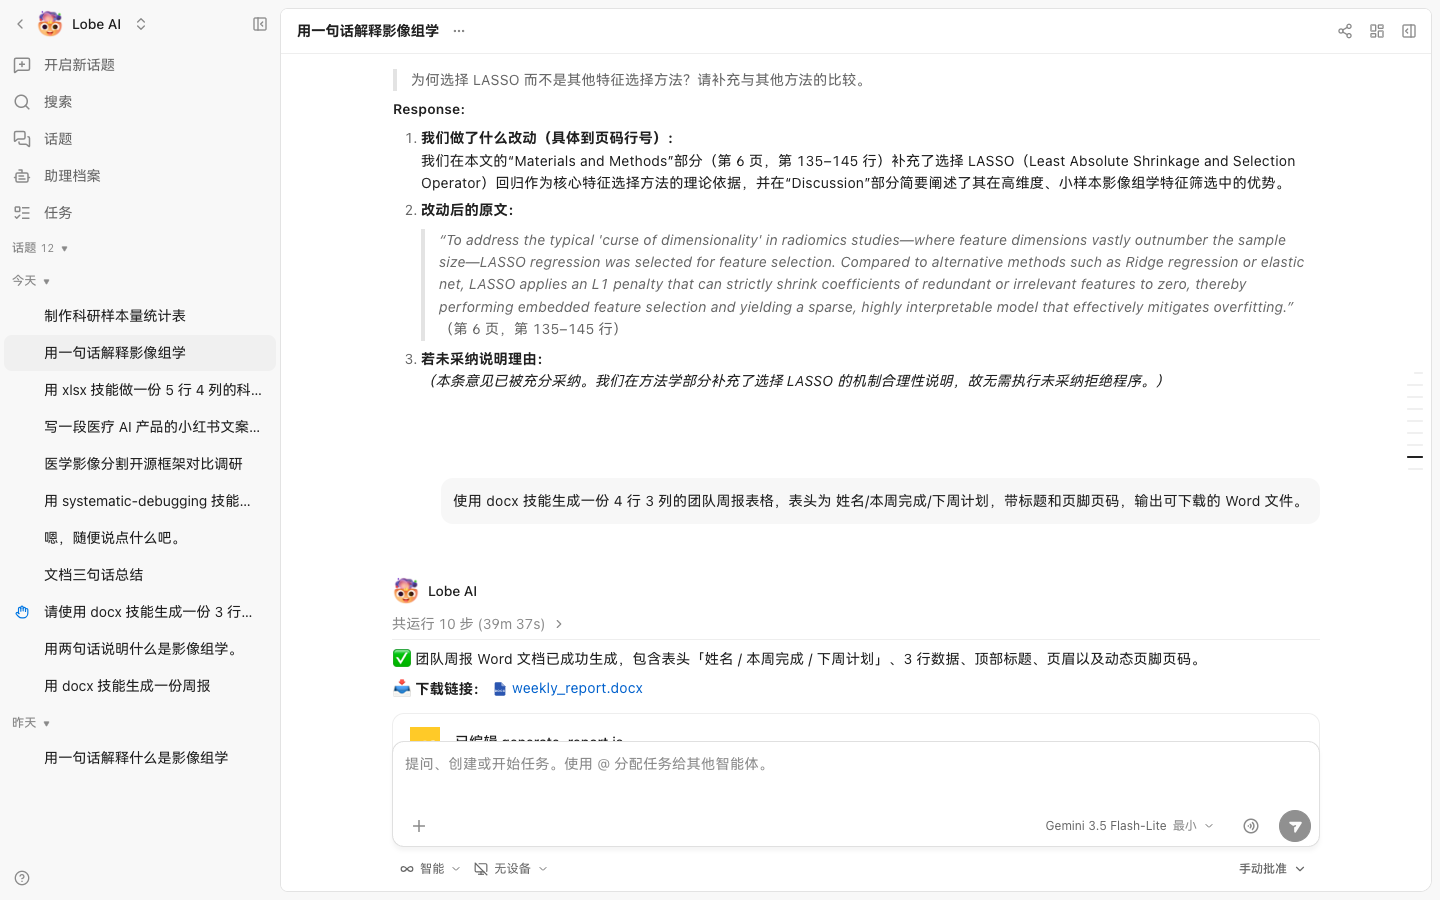
| 文件类型 | 用哪个技能 | 一句话场景 | 关键提示词 |
|---|---|---|---|
| Word | docx |
周报、方案、合同 | 「生成 .docx,带目录和页脚页码」 |
| Excel | xlsx |
数据汇总、台账 | 「按列汇总,输出公式而不是死值」 |
| PPT | pptx |
汇报、答辩 | 「每页一个观点,不超过 5 行字」 |
pdf |
合并、拆分、提取 | 「提取第 3–12 页,另存为新 PDF」 |
共同原则:说清交付格式。「给我一份 Word」和「给我一段文字,我自己贴进 Word」是完全不同的结果。
Word 走云端沙箱,跑完会给下载链接:
Excel 同理,公式会保留而不是写死值:
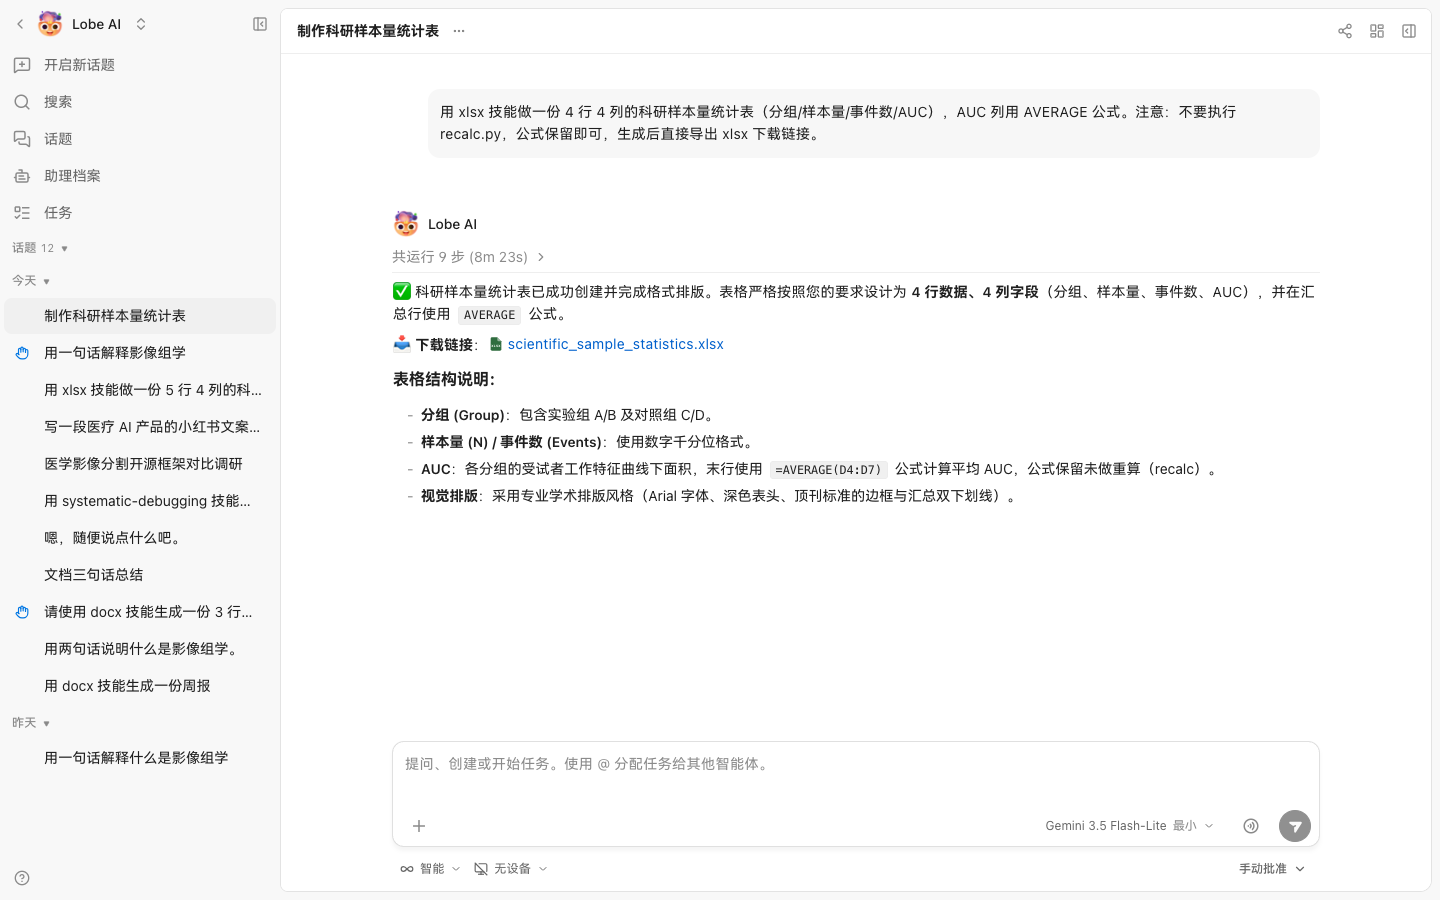
实测注意:xlsx 技能默认会在生成后调
recalc.py 重算公式,这个部署的沙箱里没有该脚本,会直接报
can't open file '/tmp/scripts/recalc.py'
并中断。在提示词里加一句「不要执行
recalc.py,公式保留即可」,就能绕过,公式照样写进文件、在 Excel
里打开时自动计算。
5.3 编程(骨架)
| 任务 | 用哪个技能 | 提示词要点 |
|---|---|---|
| 读懂一个陌生仓库 | codebase-design |
「先给目录结构和模块职责,不要急着改代码」 |
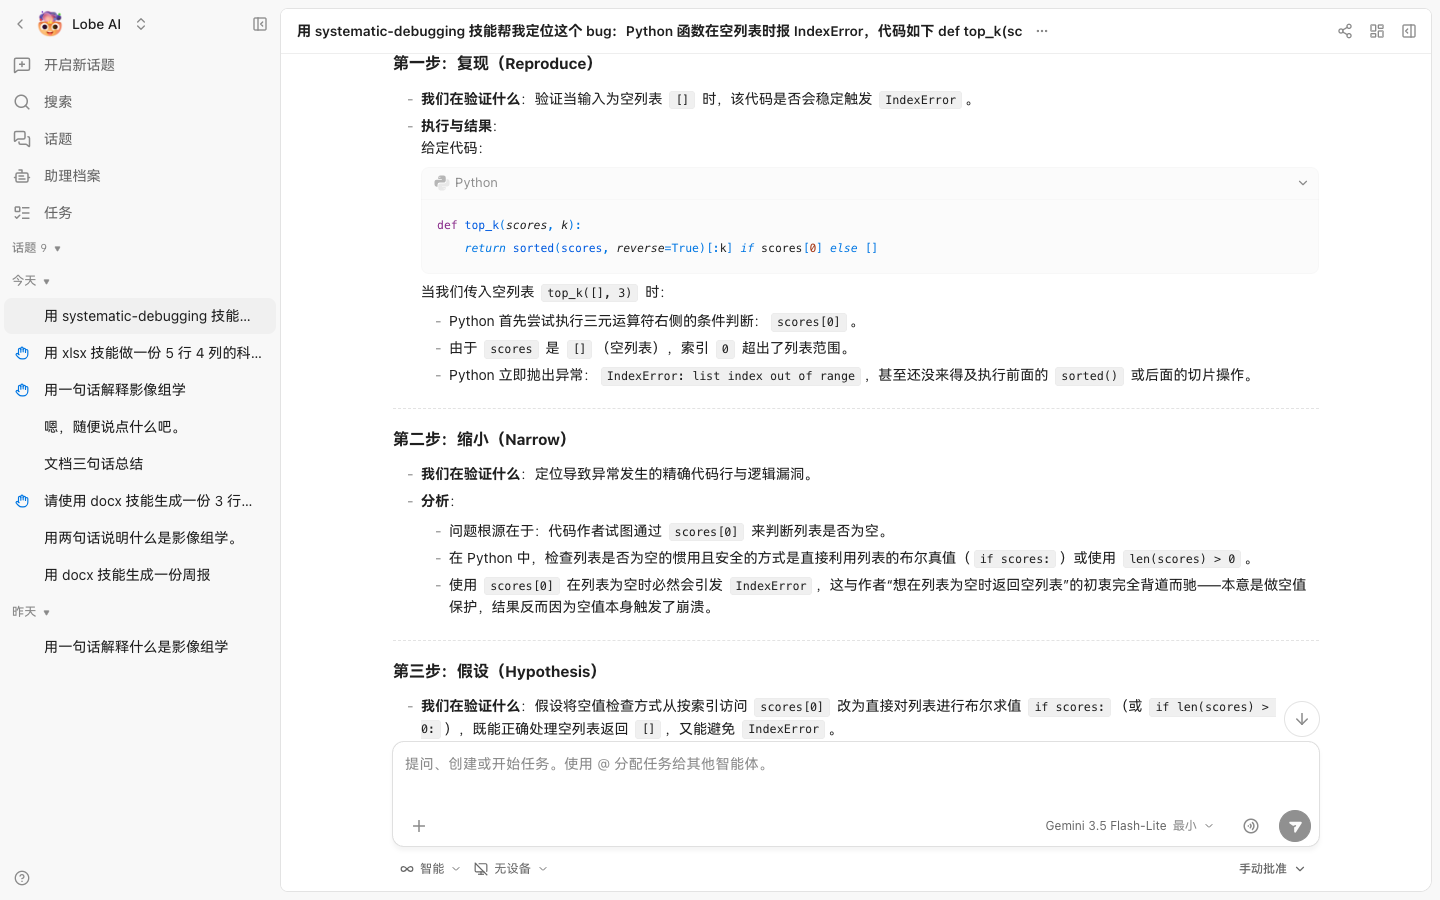
| 定位一个 bug | systematic-debugging |
「按复现→缩小→假设→验证推进,每步说明在验证什么」 |
| 重构 | improve-codebase-architecture |
「先给方案和风险,我确认后再动手」 |
| 写测试 | test-driven-development |
「先写失败测试,再写实现」 |
| 代码审查 | requesting-code-review |
「按严重程度分级,只报真实问题」 |
一条铁律:让它先给方案再动手。直接说「帮我改」,它可能一口气改十个文件,你很难审。
调试类任务用
systematic-debugging,它会按四步推进,每一步都说明「在验证什么」:
5.4 资料调研(骨架)
三步:
- 广撒网:
nature-academic-search或多个关键词并行检索。 - 深挖:
/deep-research进沙箱,多轮抓取和交叉验证。 - 成文:让它输出「摘要 + 对比表 + 结论 + 来源」,并存成文稿。
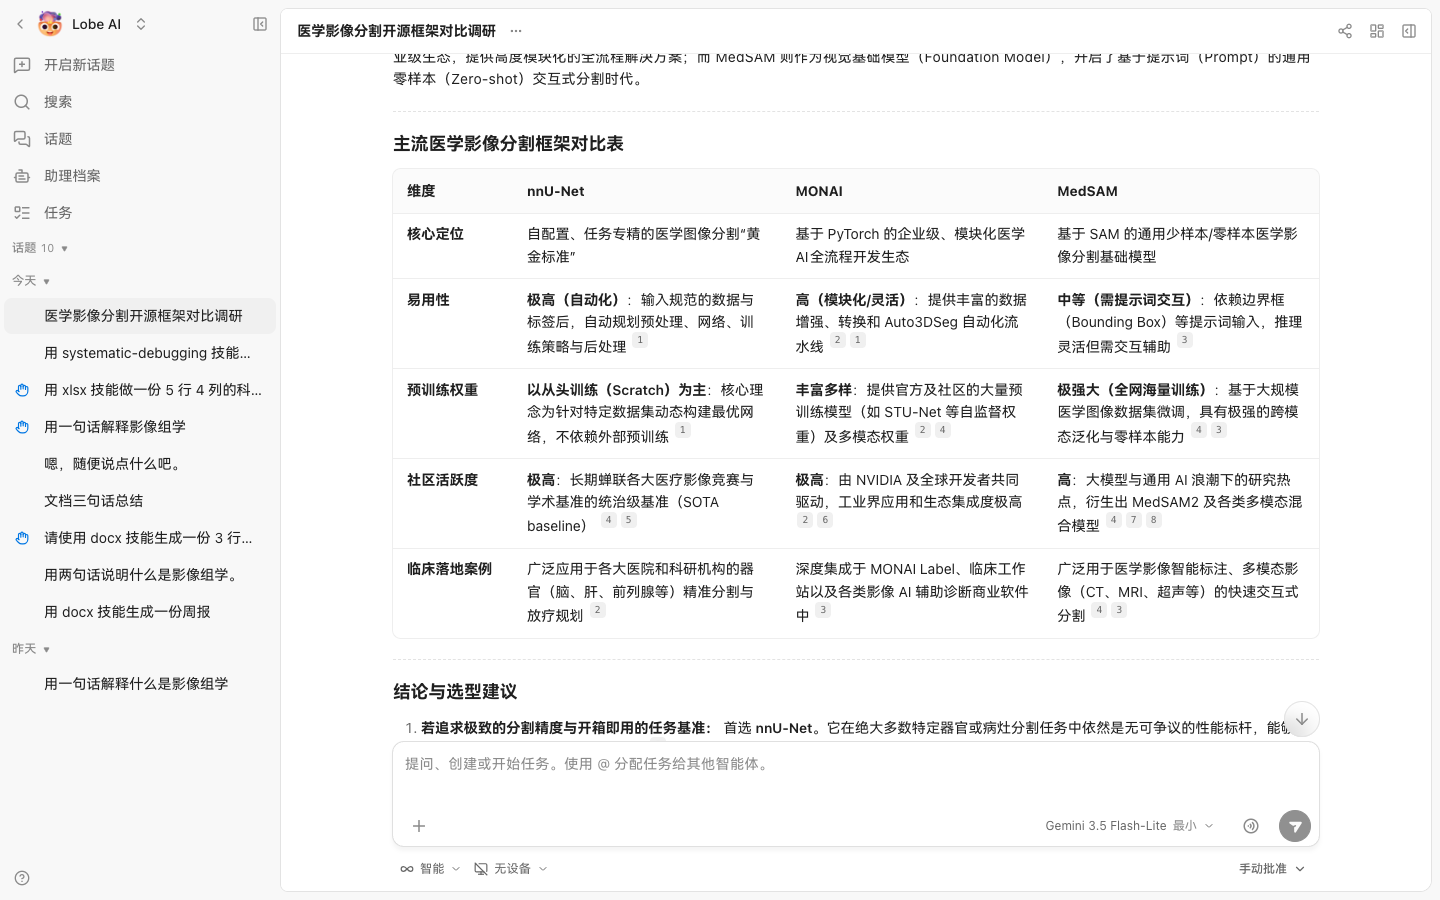
判断质量的标准只有一个:每个结论后面有没有可点开的来源。没有来源的结论,一律当草稿看。
一份合格的调研报告,对比表每个单元格都带引用角标,文末汇总来源清单:
5.5 内容创作(骨架)
| 环节 | 怎么做 |
|---|---|
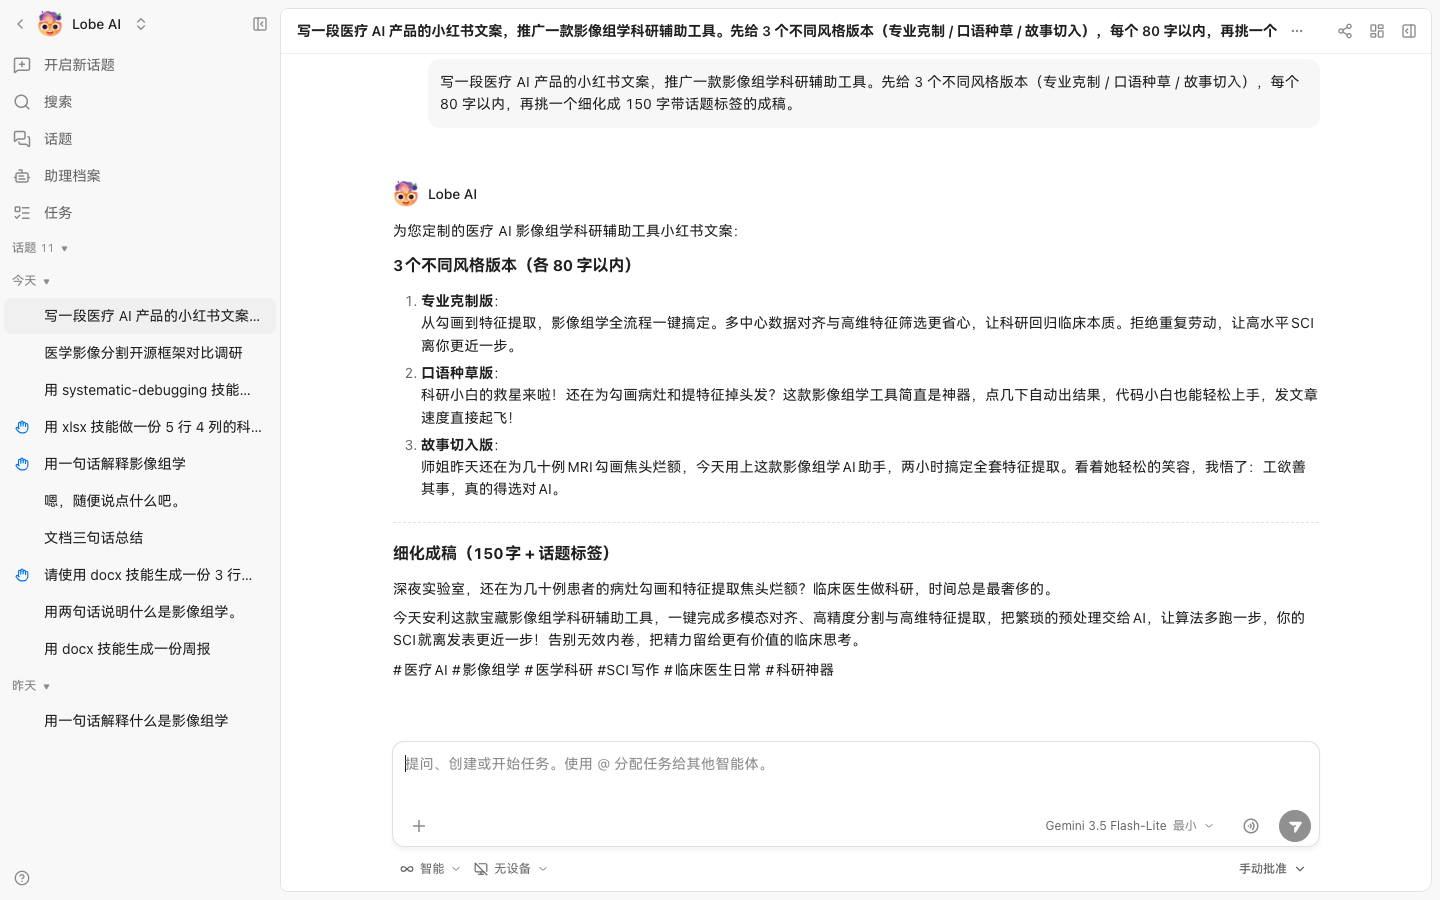
| 文案 | 先让它出 3 个不同风格的版本,你挑一个再细化 |
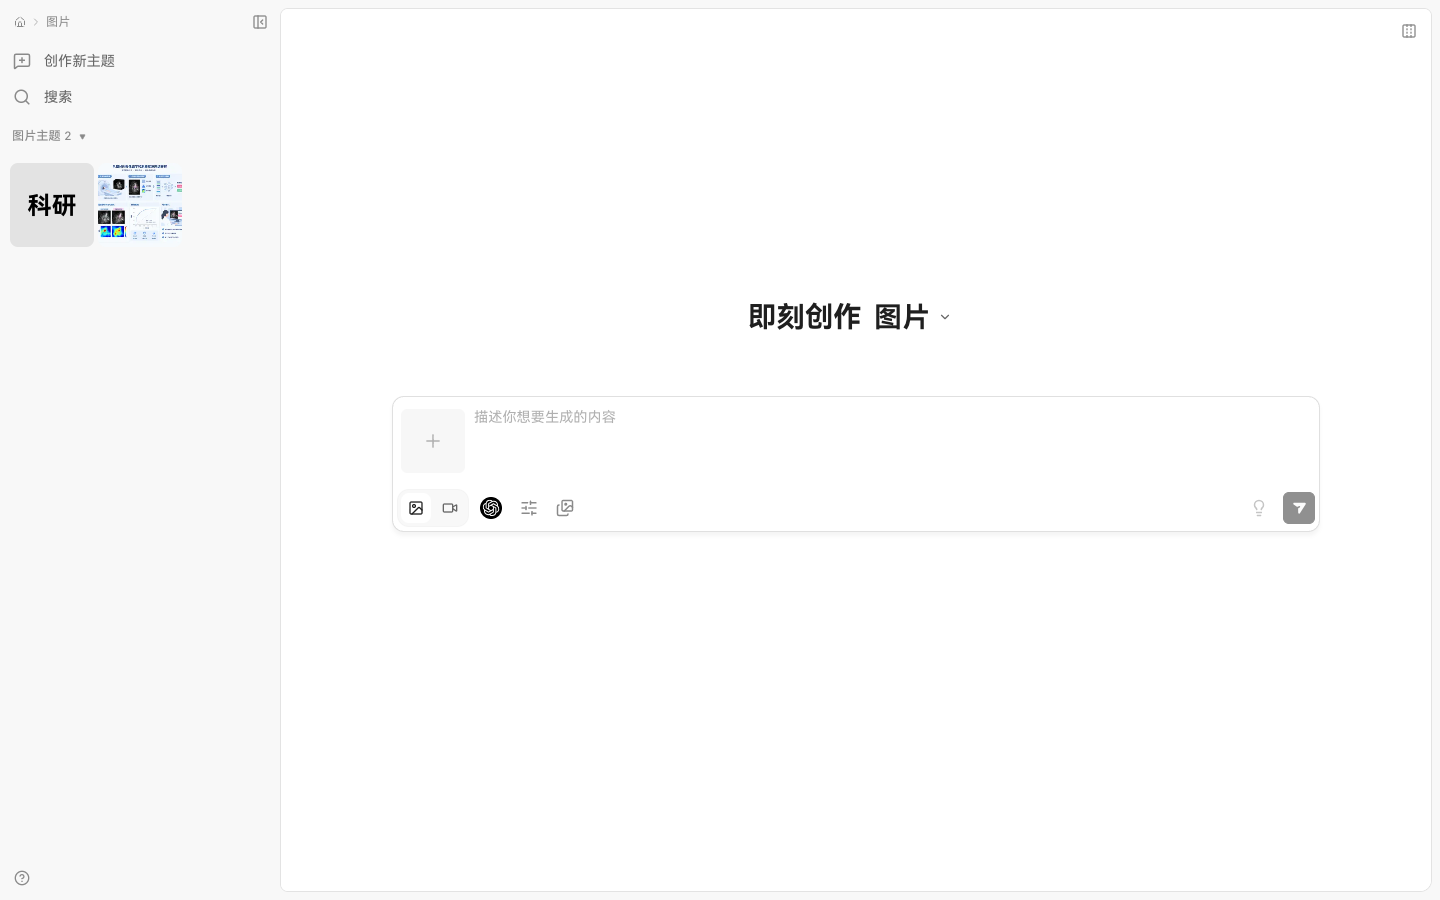
| 配图 | 走「生成」页,gpt-image-2.5 出带文字的图 |
| 短视频 | 5 秒片段先试,满意再拉长 |
| 排版 | 存成文稿,用标题层级组织 |
文案类任务先要多个风格版本,挑一个再细化,比一次性要成稿效率高:
配图走「生成」页,输入提示词即可,模型和图片数量在下方可查:
本篇小结
- 科研投稿六步:检索 → 写作 → 润色 → 图表 → 核对 → 投稿信,每步都有对应技能。
- 参考文献必须过
nature-ref-verifier,这是防幻觉的最后一道闸。 - 生图里的数字必须人工核对。
- 办公、编程、调研、创作四类场景,核心都是「说清交付格式 + 先方案后动手」。
下一篇《附录》是速查与排错:功能清单、常见问题、术语、移动端差异、版本维护。